札記第 1 則
洩漏整段影片的資料切分
- 問題
- Roboflow 版本的 Brackish 把全部 89 段來源影片同時分到訓練、驗證及測試集。同一片段的畫面出現在切分兩邊,會令驗證分數虛高。
- 決定
- 每段影片只放入一個切分。嘗試 500 種片段次序,選出驗證集及測試集最貼近整體類別比例的一種,過程不參考任何模型結果。
- 結果
- 14,674 張圖像分為訓練 11,612 張、驗證 1,575 張及測試 1,487 張,沒有片段橫跨兩個切分。不過同一固定鏡頭的不同片段,畫面仍可能相似。
協作項目・協助四人畢業專題團隊
協助一支四人香港都會大學畢業專題團隊,研究視覺模型在水底、惡劣天氣、細小物件及偽裝情況下的偵測能力:借助 Claude Code 建立共用程式碼,並完成全部四個方案的真實數據基準模型。
數字紀錄
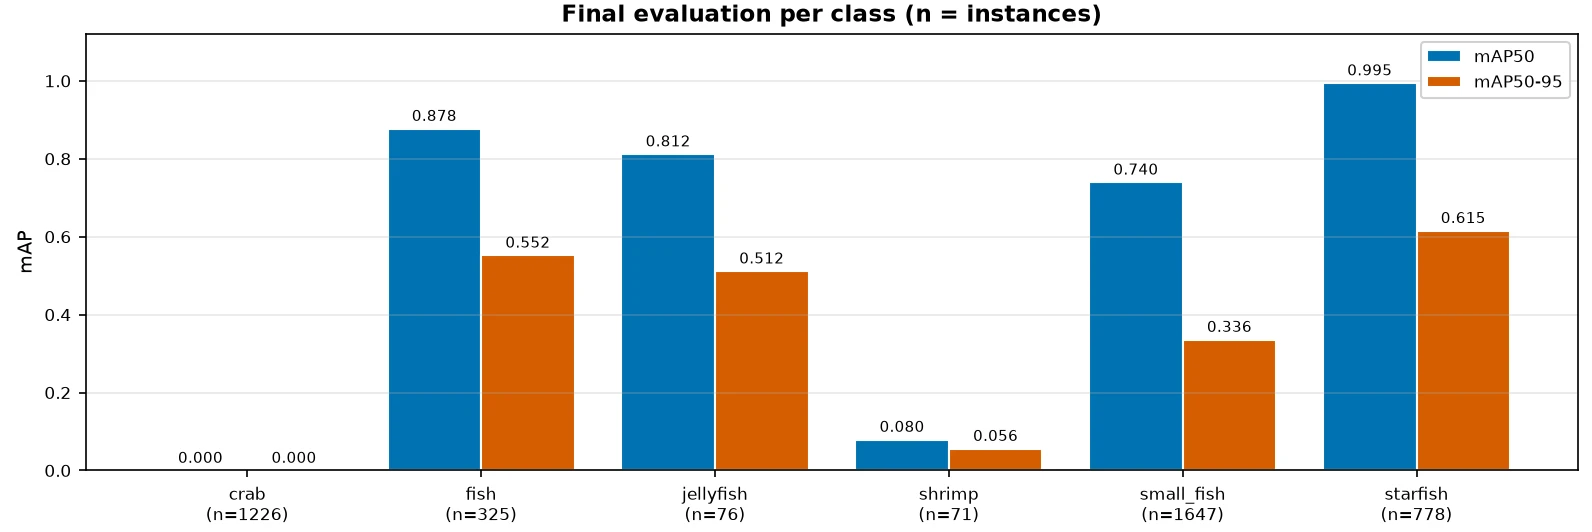
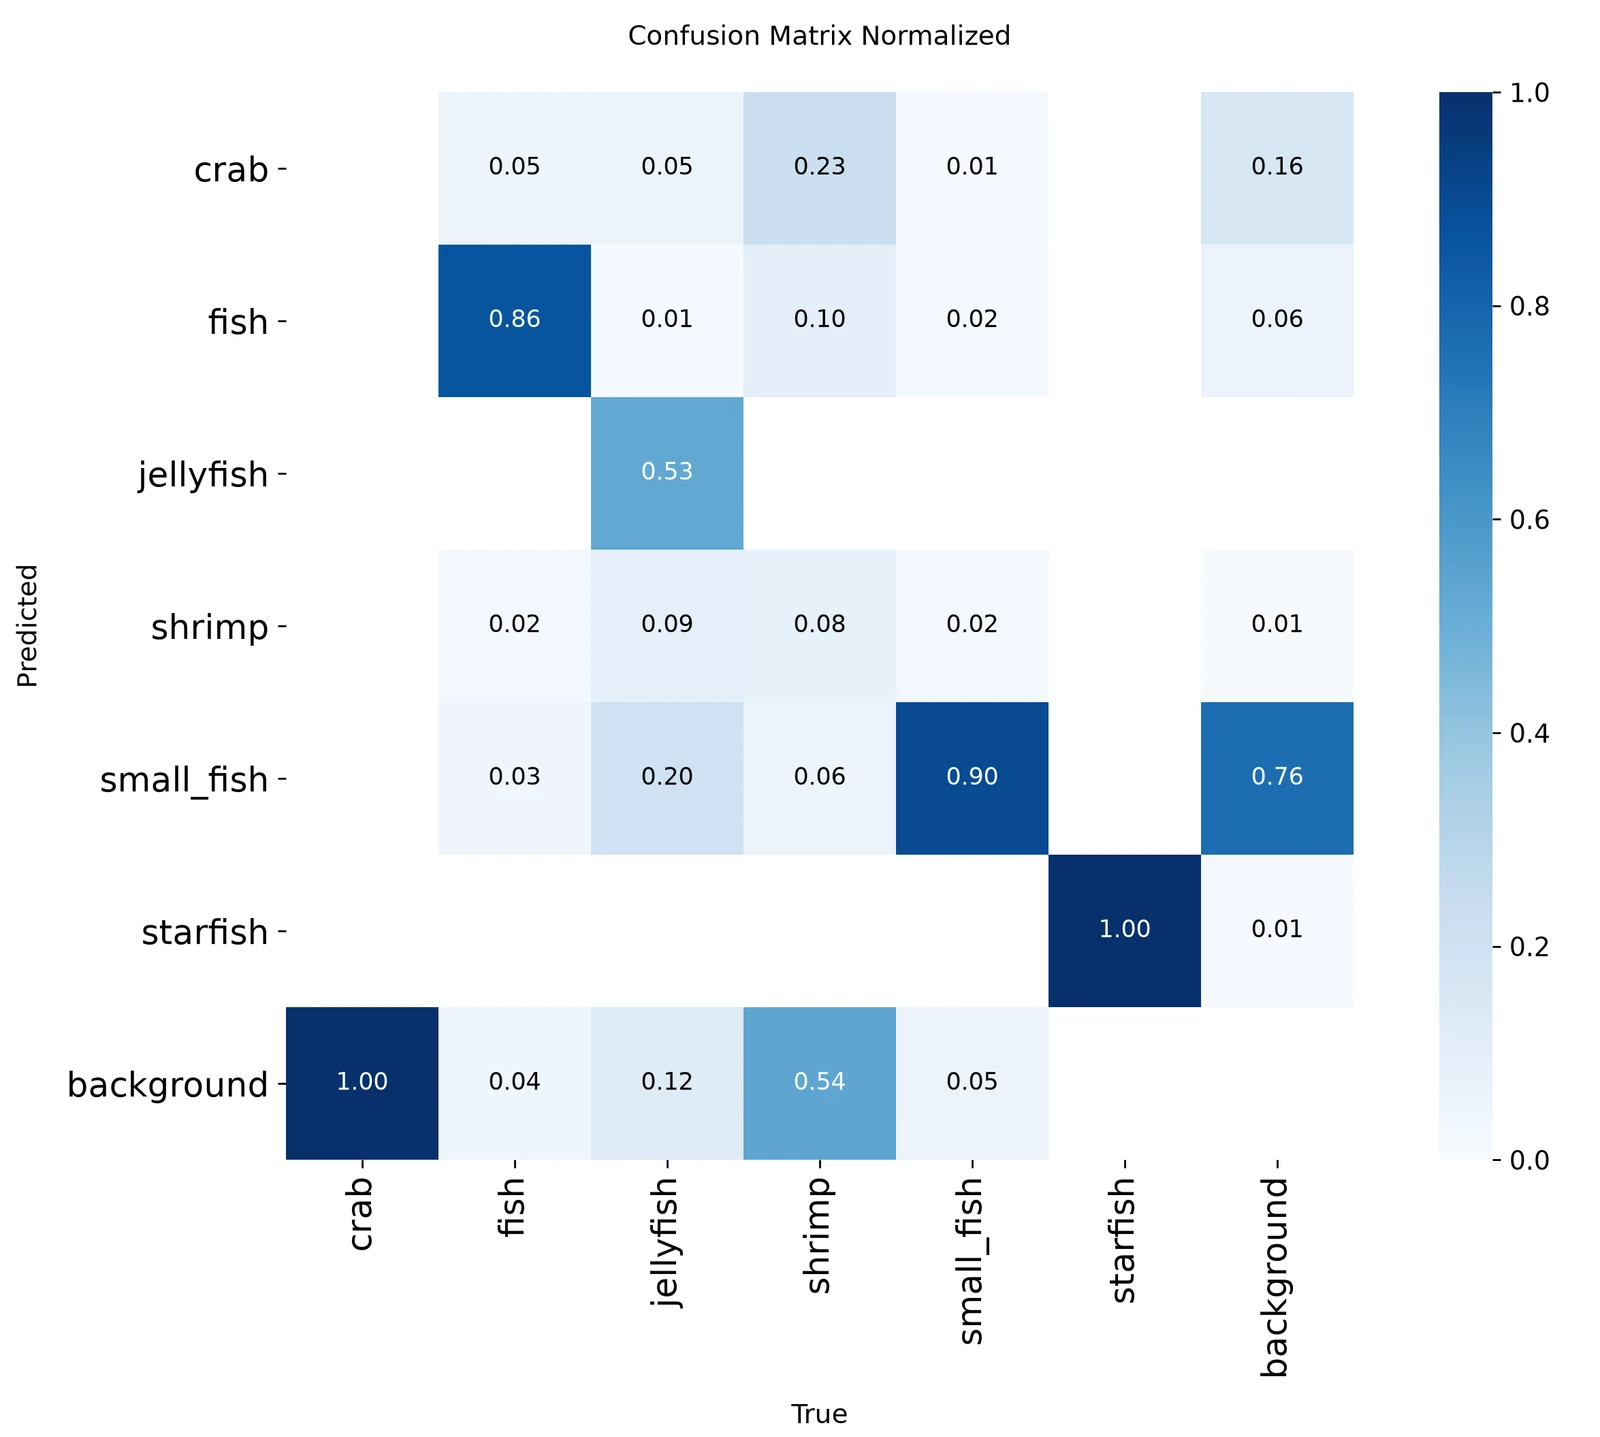
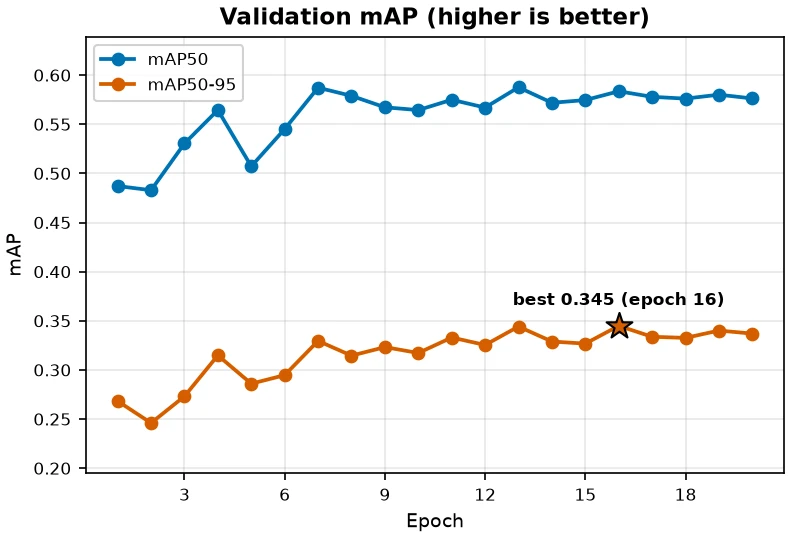
0.584mAP50,20 個 epoch 的水底基準模型一支四人香港都會大學畢業專題團隊正研究電腦視覺模型在水底、惡劣天氣、細小物件及偽裝情況下的偵測能力,所有工作集中於同一程式庫,並設有四分頁示範程式。本人借助 Claude Code 負責共用的訓練、評估及結果紀錄程式碼,並完成首個真實數據基準模型:YOLO26n 於 Brackish 訓練 20 個 epoch,單一隨機種子,驗證 mAP50 為 0.584、mAP50-95 為 0.345。同一次訓練中,蟹的 AP 為 0.000,原因至今未明。其後本人透過遙距連線,在隊友效能較佳的電腦上完成全部四個方案的第一階段基準訓練(PR #4,尚未合併),僅使用種子 0:DAWN 的 mAP50 為 0.635、VisDrone 為 0.291,COD10K 的 S-measure 為 0.853。這些只是基準模型:團隊的注意力、知識蒸餾及邊緣方法尚未以真實數據訓練。
資料集清單
以一個 JSON 檔案記錄各資料集的來源、授權備註及下載步驟。
告知腳本要取得甚麼
資料準備
由腳本準備及檢查 Brackish 與 DAWN,再寫出固定的切分清單,其中 Brackish 按影片片段切分。
固定的訓練及驗證清單
模型定義
Ultralytics 固定於 8.4.175;以生成的 YAML 檔案及層對應表加入自訂層,毋須修改函式庫。
模型來源及訓練器類別
共用訓練流程
方案 A、B、C 經同一流程以 640 像素及 nms=False 訓練;方案 D 則使用獨立的純 PyTorch 流程。
評估訓練所得權重
結果紀錄
每次訓練新增一行 CSV,記錄指標、偵測頭、GPU、提交編號、函式庫版本及時間。
儲存該次訓練的圖表
圖表
每次訓練生成一幅 Matplotlib 圖表,顯示損失、mAP 及各類別分數;選定的圖表會連同結果一併提交。
札記第 1 則
札記第 2 則
札記第 3 則
def assignClipsToSplits(imageCountByClip, seed):
    clipNames = sorted(imageCountByClip)
    random.Random(seed).shuffle(clipNames)
    totalImages = sum(imageCountByClip.values())
    assignment, filledImages = {}, {"val": 0, "test": 0}
    for clipName in clipNames:
        openSplit = next((splitName for splitName in ("val", "test") if filledImages[splitName] < holdOutFraction * totalImages), None)
        assignment[clipName] = openSplit or "train"
        if openSplit: filledImages[openSplit] += imageCountByClip[clipName]
    return assignment
驗證集及測試集按打亂後的片段次序填滿,餘下的全部作為訓練數據,因此每段影片只會整段分配。
# Which YOLO26 head produces the reported accuracy. In Ultralytics 8.4.175, val, predict and the validation inside training use the
# one-to-many head with external NMS unless nms=False is passed (the default nms=None means external NMS). The speed protocol times
# the NMS-free one-to-one head, so accuracy is measured on that same head: every train, val and predict call passes these arguments.
# Models without a one-to-one head (YOLO11, YOLOv8 reference rows) ignore the setting and keep using NMS.
# This is a protocol decision for the whole team: change it only by agreement and record it in plans/decisions.md.
endToEndArguments = {"nms": False}
# Text added to the notes of every results row so the head used for a number is never ambiguous
endToEndNote = "head=one2one(nms=False)"
這項設定集中在一處,其備註會寫入結果列,因此紀錄的數字會標明由哪個偵測頭得出。
此項目沒有錄影片段。
2026年10月23日
全部四個方案的第一階段基準模型完成紀錄(PR #4,尚未合併)
里程碑2026年10月22日
水底基準模型併入 main 分支(PR #2)
里程碑2026年10月22日
全方案訓練驅動腳本完成初稿;PR #3 未經合併便關閉
里程碑2026年10月18日
20 個 epoch 水底基準模型:mAP50 0.584,單一隨機種子
里程碑2026年10月17日
加入結果圖表,完成首個真實訓練 epoch
里程碑2026年10月17日
共用程式碼併入 main 分支(PR #1)
里程碑2026年10月17日
Brackish 按影片片段重新切分
里程碑2026年10月11日
四個方案的程式碼完成初稿;開啟 PR #1
里程碑2026年10月11日
加入項目管治文件
里程碑